Топ сервисов транскрибации аудио: ИИ и нейросети для расшифровки аудио в текст
Ручной набор текста отнимает много времени. Нейросети превращают речь в текст сами, а вам остаётся проверить результат.
Чтобы превратить аудио в готовый текст, достаточно загрузить файл. Расшифровать аудио можно и бесплатно, но лимиты у сервисов свои. Короткую запись многие сервисы обрабатывают и отдают текст за пару минут.
Задача простая: расшифровать запись быстро и точно. Но условия у сервисов разные: лимиты, языки, доступ из вашей страны.
Это не рейтинг по точности, а подборка из пяти сервисов, которые представляют разные классы. В неё вошли локальная модель, облачные API, веб-сервис для файлов и сервис для встреч.
Если нужно расшифровать лекцию, интервью или созвон, выбор зависит от типа записи. Начнём с коротких выводов.
Ключевые выводы
Единого лучшего сервиса нет: выбор зависит от записи, от вашей страны и от того, готовы ли вы что-то устанавливать.
- Whisper (локальная модель). Бесплатный и без лимитов, а файлы остаются на вашем компьютере. Взамен придётся установить и настроить программу.
- SpeechKit (облачный API). Час аудио обходится от 9 ₽ в отложенном режиме. Подходит для автоматической обработки записей, но работает через API.
- ElevenLabs Scribe (облачный API). Разделяет до 32 голосов в одной записи, но с ограничением доступа из России.
- Speech2Text (веб-сервис для файлов). Работает без установки и даёт 180 бесплатных минут при регистрации. Дальше действует суточный лимит.
- mymeet.ai (сервис для встреч). Подключается к Zoom, Google Meet, Телемосту и SberJazz и показывает, кто говорит. Бесплатно доступны 180 минут в месяц.
Что учесть до загрузки записи:
- Условия меняются. У сервисов автоматической транскрибации лимиты и цены пересматривают: SaluteSpeech от Сбера с 15 июля 2026 года перестал продавать новые пакеты.
- Данные. Если в записи есть персональные данные, сначала выясните, где сервис их обрабатывает: законы РФ требуют хранить такие данные на территории страны.
- Черновик. ИИ для транскрибации даёт черновик, а не окончательный текст. Имена и цифры проверяйте вручную: в исследовании 2023 года Whisper иногда добавлял фразы, которых не было в записи.
Как выбирали сервисы: критерии, точность и формат файла
Ключевой критерий - точность расшифровки русской речи. Но собственного теста для этой подборки нет.
Высокая точность заявлена у каждого сервиса, но проверить её без теста нельзя. Поэтому мы сравниваем документированные параметры и не приводим проценты.
Остальные параметры показывают, подойдёт ли сервис именно вам. Мы сравнивали сервисы по шести параметрам:
- качество распознавания речи на русском
- определение спикеров
- формат файла на входе: аудио или видео
- формат файла на выходе: текст или субтитры
- лимиты и тариф
- доступность и хранение данных
Охват языков разный: у Playground SpeechKit их 16, у ElevenLabs Scribe больше 90. Сервиса, который заявлял бы 100 языков, мы не нашли.
Для интервью и созвонов отдельно смотрим на качество разбивки по спикерам. Если в записи много специальных терминов, проверьте, можно ли добавить их список. Отдельно оценивайте, как сервис справляется с шумными записями.
Мы оценивали только автоматический режим, без ручной правки текста. Корпоративный тариф не сравнивали: у него отдельные условия. Интеграция с Zoom или Телемост важна лишь для сервисов, которые записывают встречи.
Из каждого класса мы взяли один-два сервиса, у которых есть официальная страница с условиями.
SaluteSpeech от Сбера в подборку не попал. С 15 июля 2026 года Сбер перестал продавать новые пакеты физлицам, а новым юрлицам закрыл покупку пакетов и оплату по факту потребления. Поэтому мы не рекомендуем сервис новым пользователям.
Топ-5: нейросети для транскрибации аудио и видео
Нейросети для транскрибации аудио устроены по-разному. Для преобразования аудио в текст подходят и локальные модели, и облачные сервисы.
Мы расставили сервисы по классам: от локальной модели до сервиса для встреч. Каждый разбор короткий: чем отличается сервис, кому подойдёт и в чём минус. Цифры по лимитам и ценам собраны в таблице ниже.
Whisper: ИИ для транскрибации, бесплатный при локальном запуске
Whisper - открытая модель распознавания речи. Её код и веса выпущены по лицензии MIT, поэтому пользоваться моделью можно бесплатно.
Модель работает на вашем компьютере, а запустить её можно и без видеокарты. Транскрипция идёт локально: файлы не уходят в облако, а запись обрабатывается без передачи третьим лицам.
Whisper умеет превращать голос в текст на русском и других языках. Заодно он умеет автоматически определять язык записи.
Для кого: для конфиденциальных записей и тех, кто хочет запустить транскрибацию аудио у себя. Минус: установка и настройка на вашей стороне, а крупным моделям требуется много оперативной памяти.
Yandex SpeechKit: распознавание русской речи через API
SpeechKit - облачный сервис Yandex Cloud. Он позволяет преобразовывать речь в текст тремя способами: потоком в режиме реального времени, синхронно для коротких файлов и асинхронно для длинных записей.
Асинхронная обработка может занять до суток. В тестовом Playground доступны 16 языков, включая русский.
Для кого: для тех, кому нужна автоматизация обработки записей в своих процессах. Минус: гибкие настройки доступны только через API, а Playground даёт базовые возможности.
ElevenLabs Scribe: расшифровка по спикерам
Scribe - модель распознавания речи от ElevenLabs. Она разделяет голоса в записи: каждая реплика получает метку говорящего.
Для кого: для интервью и дискуссий с несколькими участниками. Минус: сервис доступен не из всех стран, подробности в блоке про доступность.
Speech2Text: транскрибация аудио и видео для лекций
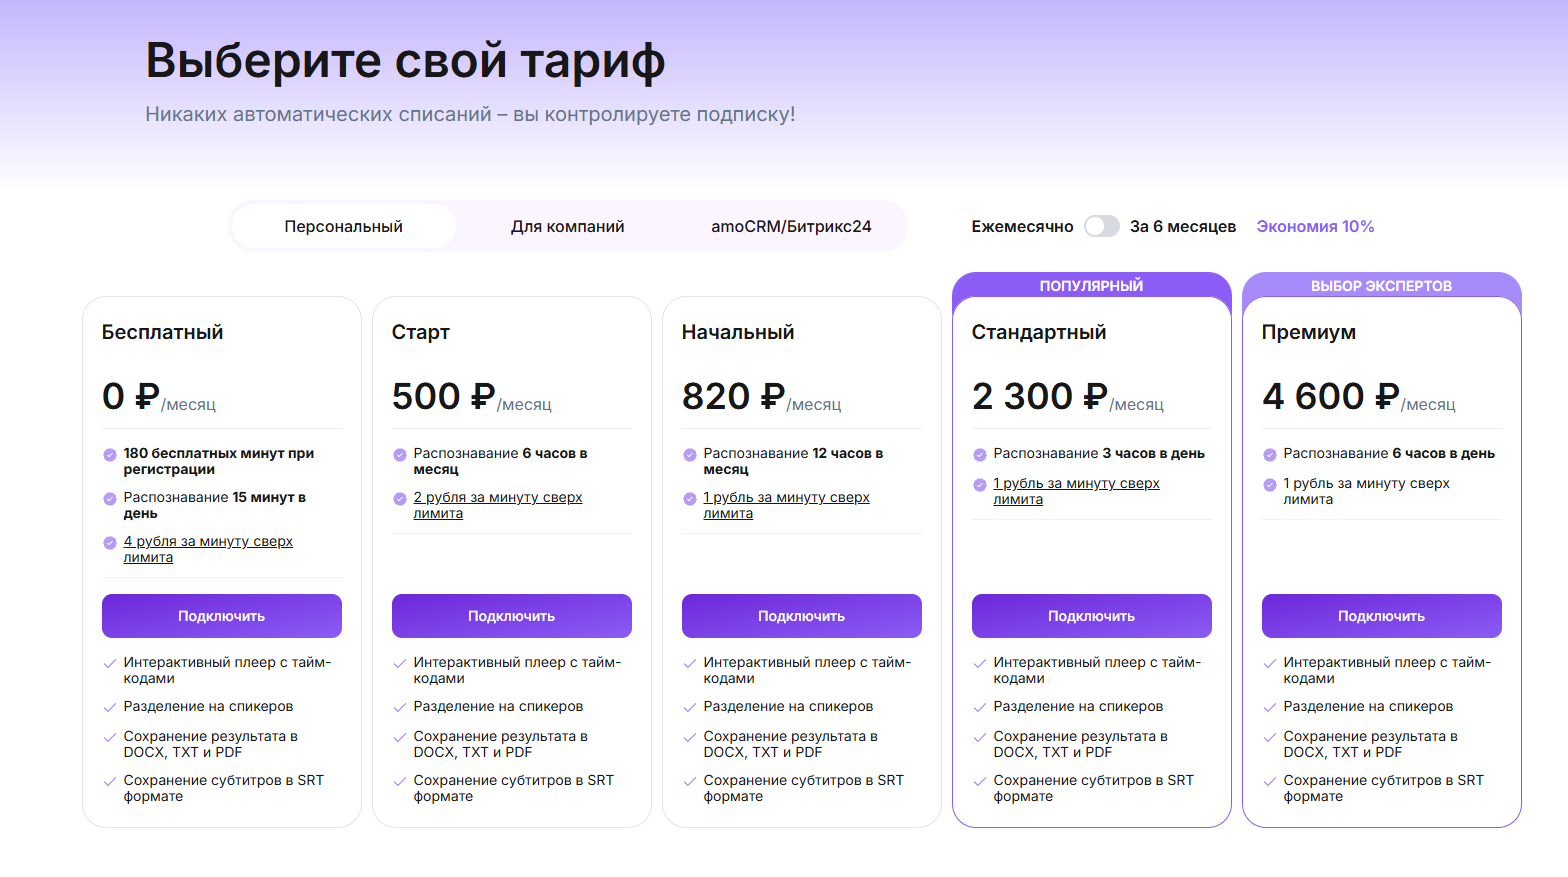
Speech2Text - российский веб-сервис для расшифровки аудио и видео. На странице с условиями указаны разделение по спикерам, сохранение результата в DOCX, TXT и PDF и субтитры в SRT. По описанию в обзоре, сервис ещё и расставляет знаки препинания.
Для кого: для лекций, интервью и конференций. Минус: бесплатное распознавание ограничено суточным лимитом.
mymeet.ai: сервис расшифровки встреч
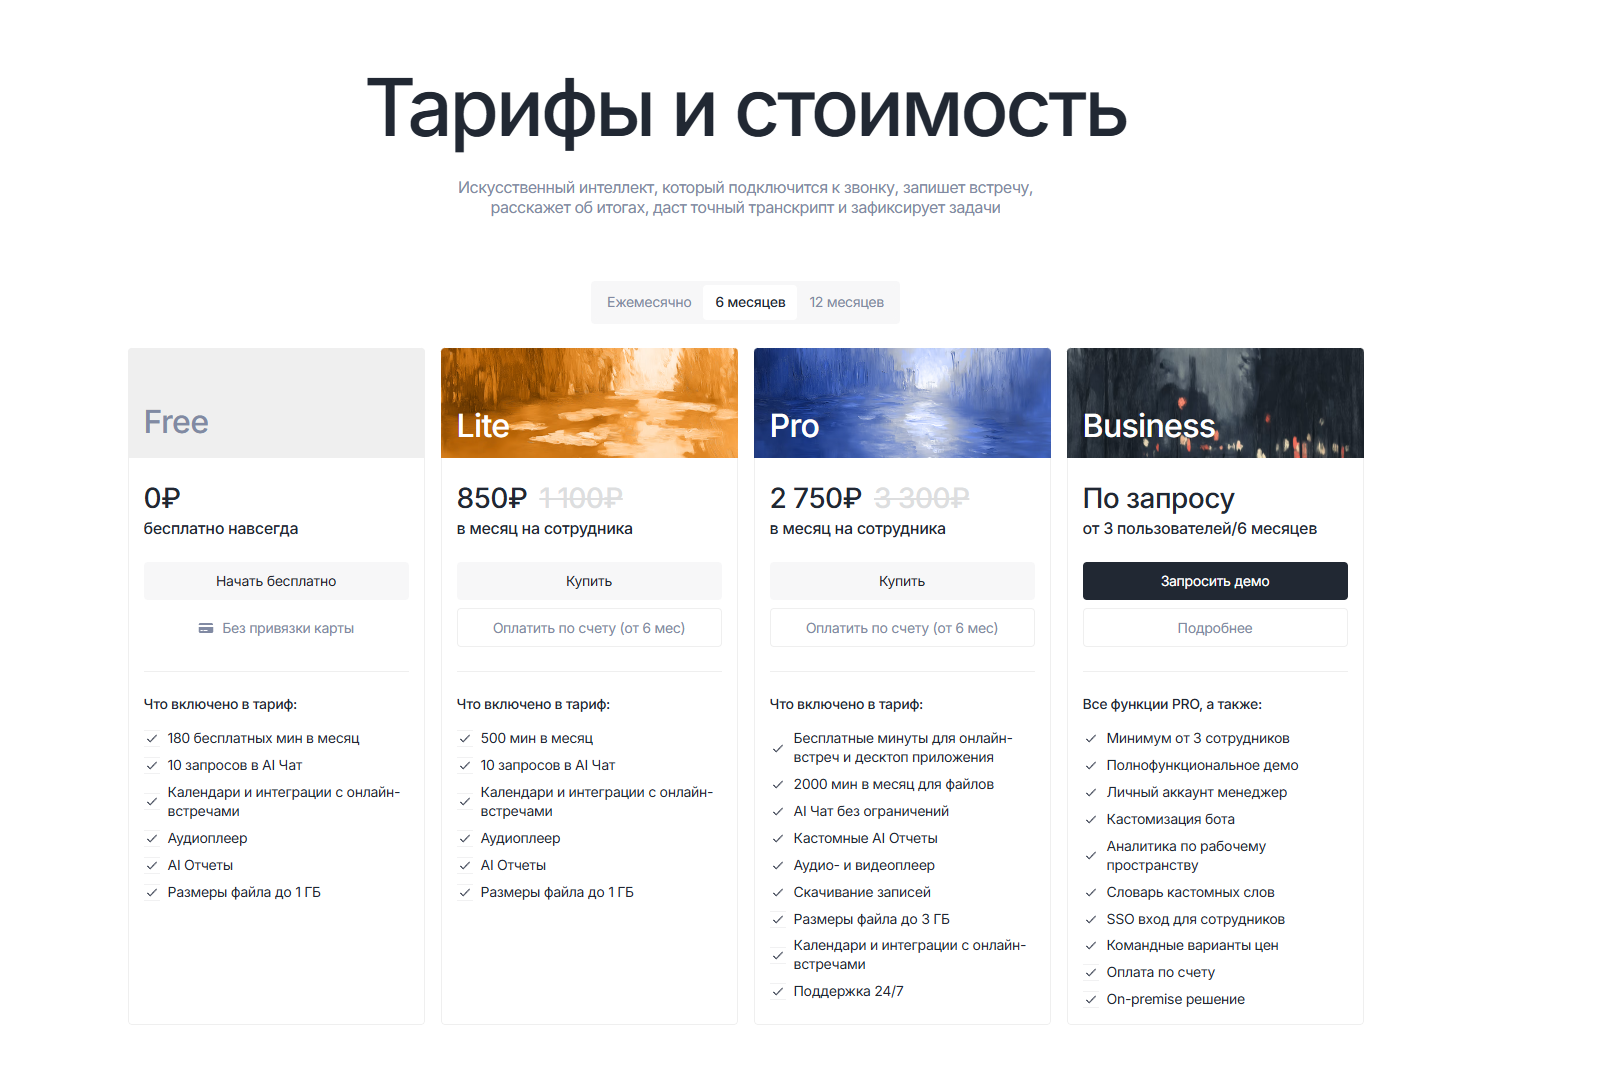
mymeet.ai - это платформа с ИИ-ассистентом для встреч. Она подключается к Zoom, Google Meet, Телемосту, SberJazz и другим сервисам видеосвязи, а в расшифровке указано, кто говорит.
Для кого: для рабочих встреч и интервью. Минус: сервис заточен под встречи, поэтому для одного готового файла он избыточен. У сервиса есть бесплатный план, лимиты смотрите в таблице.
Сравнение лучших сервисов: аудио и видео в текст в одной таблице
Таблица собрана по официальным страницам и документации сервисов на ноябрь 2026 года.
Платные тарифы считаются в разных единицах: за 15 секунд, за час или за месяц. Для сравнения сервисов транскрибации мы привели их к цене за час аудио. Для подписок стоимость часа рассчитана при полном использовании месячного лимита.
Некоторые сервисы пересматривают условия, поэтому перед оплатой сверьте цифры с сайтом. Бесплатный объём указан только там, где его подтверждает официальная страница. Среди бесплатных сервисов без лимитов остаётся только локальный Whisper.
| Сервис | Класс | Вход | Бесплатный объём | Цена за час аудио (в валюте сервиса) | Спикеры | Экспорт | Доступ из РФ |
|---|---|---|---|---|---|---|---|
| Whisper | Локальная модель | Аудиофайлы | Без лимита, лицензия MIT | 0 ₽ за использование модели, требуются вычислительные ресурсы | Встроенной разметки нет | txt, srt, vtt, tsv, json | Локальный запуск |
| Yandex SpeechKit | Облачный API | Аудио: LPCM, OggOpus, MP3 | - | 36 ₽ (асинхронно), 9 ₽ (отложенный режим), 39 ₽ (синхронно и потоком) | До двух дикторов, только API v3 и моно | Текст и список слов в ответе API | Да |
| ElevenLabs Scribe | Облачный API | Аудио и видео: MP3, WAV, M4A, FLAC, OGG и видеофайлы | 10 000 кредитов в месяц на веб-платформе | 0,2 $ (Scribe v3, файлы), 0,22 $ (Scribe v3 Live) | До 32 | txt, docx, pdf, srt, vtt, json, html | Нет |
| Speech2Text | Веб-сервис для файлов | Аудио и видео (по описанию) | 180 минут при регистрации, затем 15 минут в день | Около 83 ₽ (тариф «Старт» при полном использовании лимита), 120 ₽ сверх лимита | Есть разделение | DOCX, TXT, PDF, SRT | Да |
| mymeet.ai | Сервис для встреч | Запись созвонов, файлы до 1 ГБ | 180 минут в месяц | 102–132 ₽ (тариф Lite при полном использовании лимита) | Транскрипт по спикерам | PDF, DOCX, MD, JSON (отчёт с транскриптом) | Да |
Цены взяты со страниц тарифов SpeechKit, ElevenLabs, mymeet.ai и Speech2Text. Пометка «Нет данных» означает, что проверяемого значения на официальной странице мы не нашли. Цены указаны в валюте сервиса, курс мы не пересчитывали.
SpeechKit считает асинхронное распознавание посекундно, а моно приравнивает к двум каналам. Поэтому час стоит 3600 секунд по 0,0101 ₽, отложенный режим — по 0,00254 ₽ за секунду.
Синхронный и потоковый режимы считаются отрезками по 15 секунд: 240 отрезков по 0,1626 ₽. Цены указаны в рублях с НДС.
У ElevenLabs стоимость распознавания через API составляет 0,2 $ за час для Scribe v3 и 0,22 $ за час для Scribe v3 Live.
SpeechKit считает асинхронное распознавание посекундно, с минимальным начислением за 15 секунд. Для одного и двух каналов стоимость одинаковая. Час аудио обходится примерно в 36 ₽ при обычной асинхронной обработке (0,0101 ₽ за секунду) и в 9 ₽ при отложенной (0,00254 ₽ за секунду).
Синхронный и потоковый режимы тарифицируются отрезками по 15 секунд: 240 отрезков по 0,1626 ₽, или около 39 ₽ за час. Цены указаны в рублях с НДС.
Доступность и данные: что проверить до загрузки записи
Перед загрузкой проверьте три вещи: из каких стран работает сервис, где хранятся файлы и как долго лежит результат.
Доступ зависит от страны. ElevenLabs ограничивает доступ из России, а SpeechKit работает в России.
Срок хранения у сервисов разный. У SpeechKit результаты распознавания хранятся 3 суток, потом получить их нельзя.
В России при сборе персональных данных граждан их по общему правилу необходимо записывать и хранить в базах на территории страны. Это требование предусмотрено ч. 5 ст. 18 закона № 152-ФЗ, новая редакция которой вступила в силу 1 июля 2025 года. Закон предусматривает отдельные исключения.
Поэтому для таких записей сначала выясните, где сервис обрабатывает файлы. Локальный Whisper этот вопрос снимает: файл не покидает ваш компьютер. Статья не заменяет консультацию юриста.
Какой сервис выбрать: лекция, интервью или встреча
Выбор сервиса транскрибации зависит от типа записи. Чтобы расшифровать запись без лишних затрат, сверьтесь с таблицей выше.
Лекция. Для расшифровки лекций с одним голосом подойдёт Speech2Text: это веб-сервис без установки, у него есть бесплатный суточный лимит. Если важна конфиденциальность, возьмите Whisper: он работает на вашем компьютере, но требует установки. SpeechKit принимает длинные записи, но работает через API.
Интервью. Если голосов несколько, смотрите колонку «Спикеры». ElevenLabs Scribe разделяет до 32 голосов, а Speech2Text и mymeet.ai тоже размечают спикеров. У SpeechKit разметка работает только для двух дикторов в монозаписи.
Встреча. Для созвонов подойдёт mymeet.ai: он подключается к видеоконференциям и показывает, кто говорит.
Как повысить точность расшифровки: запись, микрофон, шум
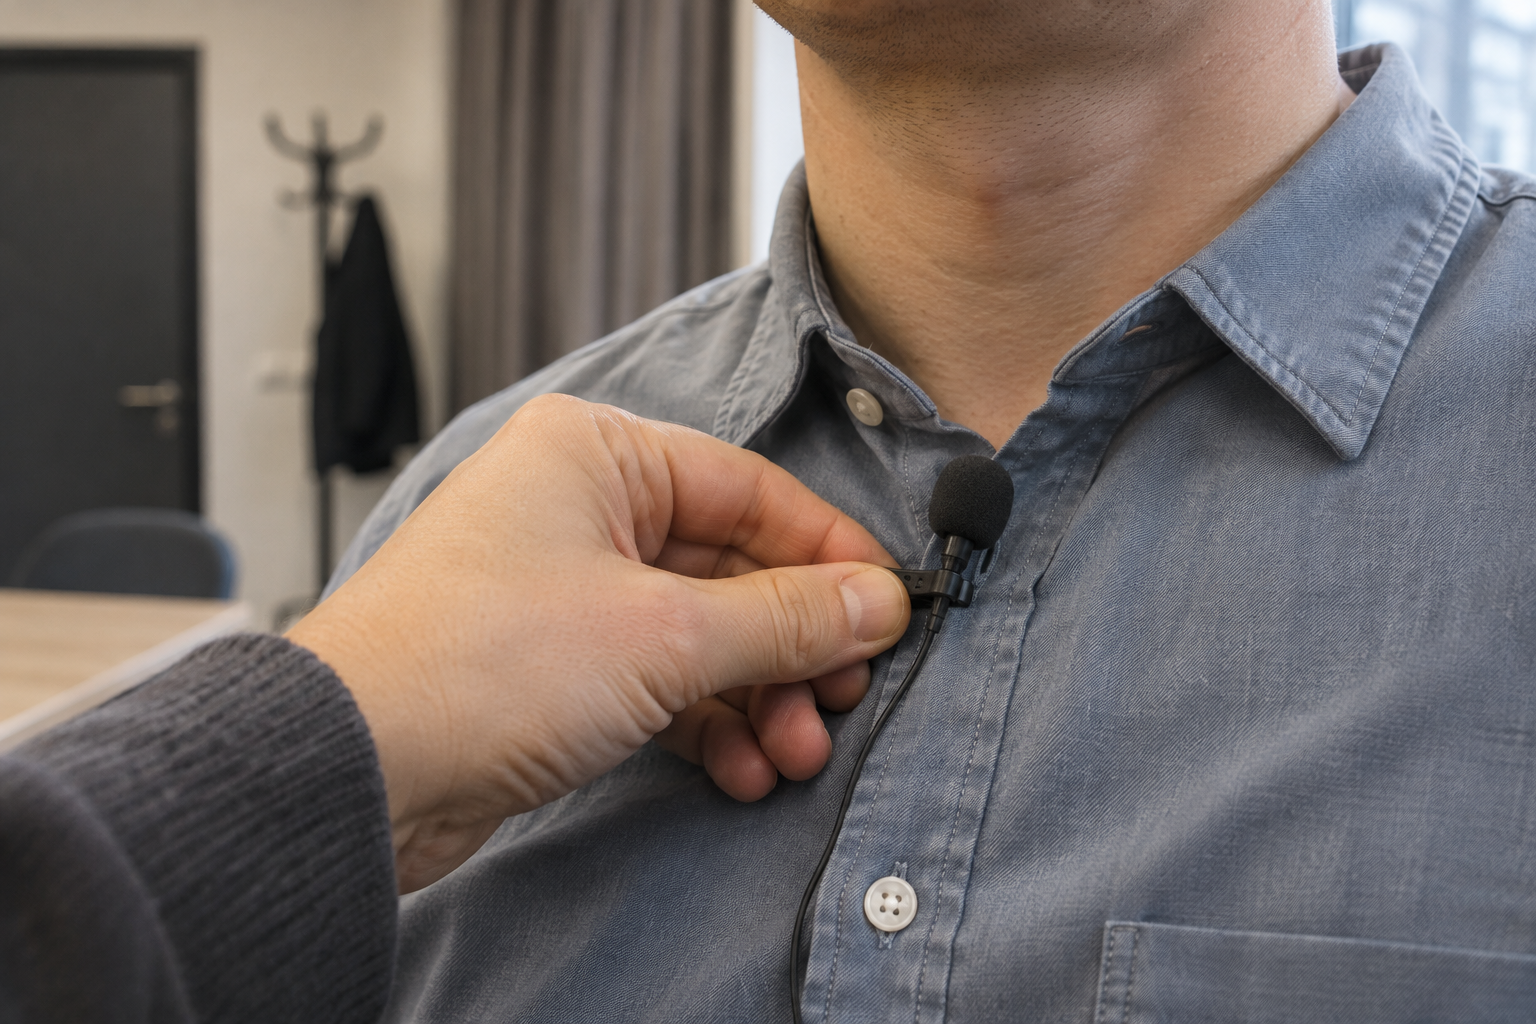
Точность расшифровки зависит и от качества записи. Записывайте в тихой обстановке: тихий кабинет лучше, чем кафе.
Google советует в документации ставить микрофон как можно ближе к говорящему, особенно при шуме. Там же рекомендуют отключить шумоподавление и автоматическую регулировку громкости: обработка до отправки обычно снижает точность. Это правила для сервиса Google, у других требования могут отличаться.
Формат файла проверьте в документации выбранного сервиса. SpeechKit, например, принимает OggOpus и MP3 без ограничений на качество, но поддержка MP3 зависит от версии API и режима распознавания.
Использование расшифровки: проверка черновика, сделанного с помощью ИИ
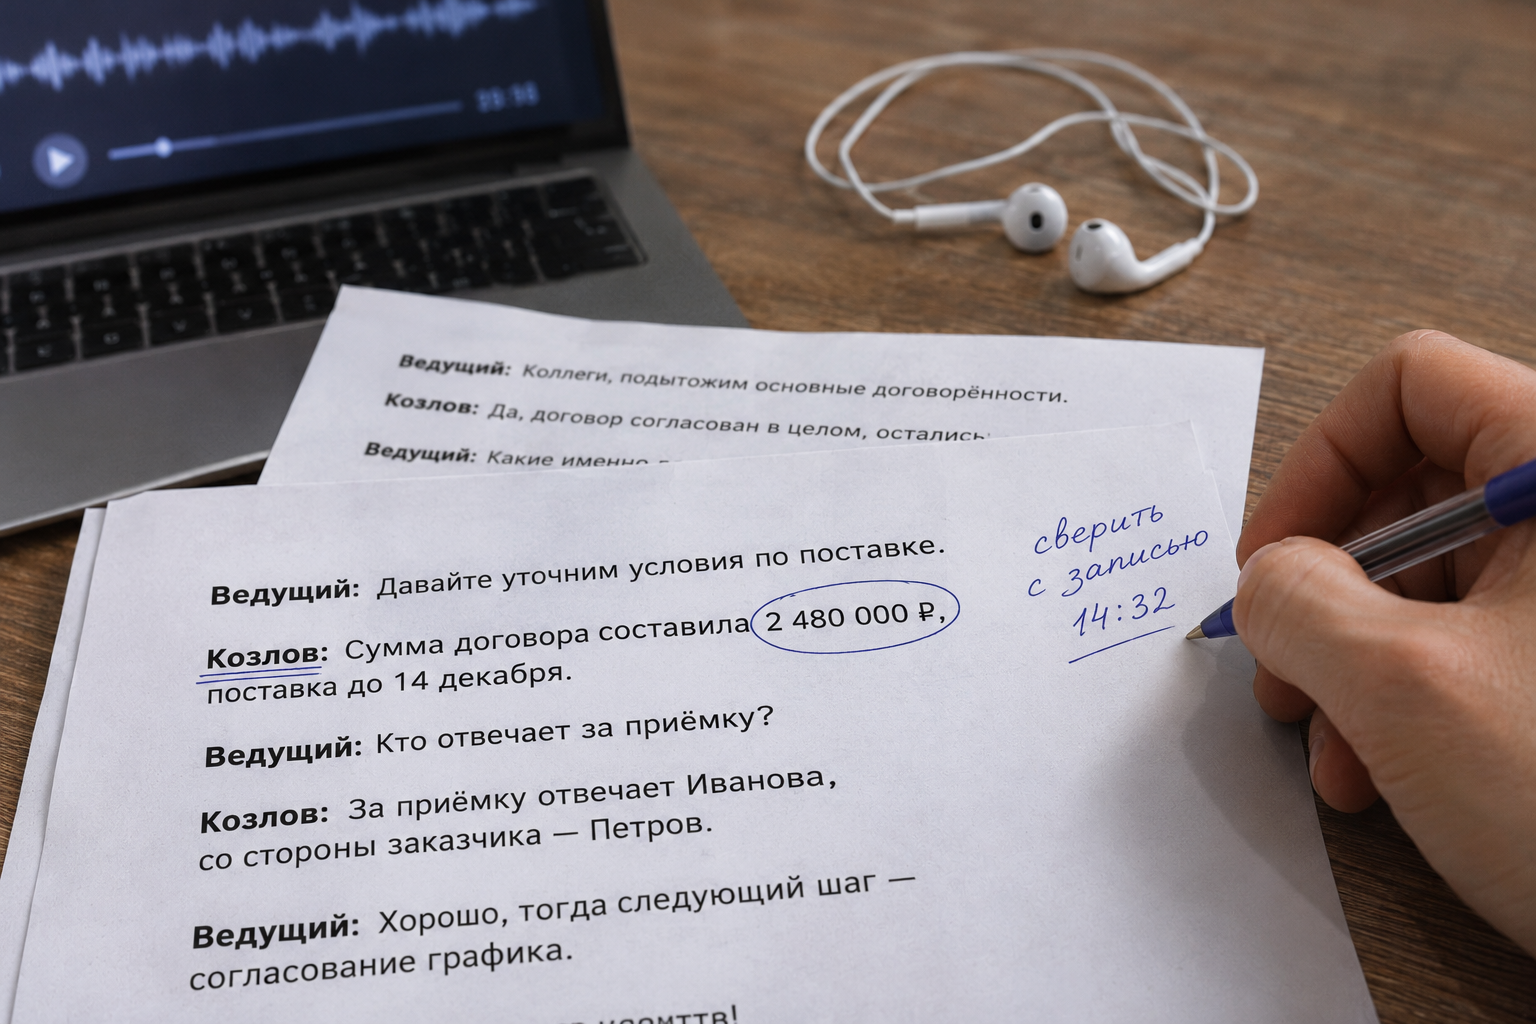
Расшифровка, сделанная с использованием ИИ, остаётся черновиком. AI расшифровку стоит сверить с записью, пока тема свежа.
Кто получил текст от нейросети, должен начать с имён и цифр. Затем проверьте написание терминов: составьте список ключевых слов записи и найдите их в тексте.
Пунктуация тоже иногда требует правки. Если сервис не разбивает текст на предложения, расставьте точки и абзацы сами.
Нейросеть может придумать текст, которого в записи нет. В исследовании Koenecke и коллег облачная модель Whisper весной 2023 года выдала такие фразы в 1,4% коротких английских аудиосегментов. Чаще это случалось там, где в записи были длинные паузы.
Русскую речь и другие сервисы исследование не проверяло, поэтому долю ошибок в вашей записи оценить нельзя. Выборочно сверяйте текст с аудио, особенно в местах с паузами.
Частые вопросы про транскрибацию аудио
Как расшифровать длинную запись?
Длинные аудиозаписи упираются в лимиты сервиса. SpeechKit, например, принимает аудио до 4 часов и файлы до 1 ГБ при загрузке через бакет. Если запись длиннее, разбейте её на части и расшифруйте по очереди.
Можно ли расшифровывать речь в режиме реального времени?
Да, если у сервиса есть потоковый режим. У SpeechKit он принимает голосовой поток по частям, но одна сессия ограничена 5 минутами и 10 МБ аудио. У ElevenLabs для этого есть модели Scribe v3 и Scribe v3 Live.
Как получить субтитры из записи?
Ищите SRT или VTT в колонке «Экспорт» таблицы: они указаны у Whisper, ElevenLabs Scribe и Speech2Text. У SpeechKit в таблице только текст и список слов. Для создания субтитров выбирайте сервис с готовым форматом.
Итоги: с чего начать
Начните с одного шага: прогоните короткий фрагмент своей записи через бесплатный объём сервиса из таблицы. Пять минут расшифровки покажут, как сервисы справляются с вашим голосом и шумом. Так можно быстро расшифровать фрагмент без оплаты.
Это быстрый способ понять, подойдёт ли вам выбранный AI-сервис, прежде чем загружать часовую запись.